김도연

PORTFOLIO 2026

BACKENDDATAINFRA

Software Engineer

정산 배치, 행동 로그 파이프라인, AWS 인프라, LLM 회의록 자동화를 만들었습니다. 처리 시간과 데이터 누락, 재실행 결과를 직접 재서 확인했습니다.

  1. TR1L10,120 → 674초108만 명 정산의 계산 단계(Step03)
  2. TR1L결함 7건94가지 장애 시나리오로 찾아 고친 재실행 결함
  3. Holliverse21,526건행동 로그 전 구간 일치
  4. Holliverse449 → 220초서비스 배포 중앙값 50.9% 단축
  5. Holliverse99.4 → 16%부하 시험 중 관리자 API CPU 최대 사용률
  6. Qello3분 이내한 편에 10~15분 걸리던 회의록 작성

수학을 전공하며 결과뿐 아니라 그 결과가 성립하는 조건을 확인하는 습관을 길렀습니다. 이후 컴퓨터공학을 복수전공하고 Java와 Spring 기반 백엔드 개발 경험을 쌓았습니다. 대용량 배치 처리와 데이터 정합성 개선, 장애 상황에서의 재실행 검증을 경험했습니다. 기능 구현에 그치지 않고 실제 운영 환경에서도 신뢰할 수 있는 시스템을 만드는 개발자가 되고자 합니다.

01PROJECTS프로젝트

  1. 01TR1L100만 명 규모 통신사 월 정산과 청구서 발송 배치
  2. 02Holliverse행동 로그 누락 원인 분석과 AWS 인프라 개선
  3. 03Qellon8n과 LLM으로 만든 회의록 자동화

PROJECT 01 / TR1L

TR1L

100만 명 규모 통신사 월 정산과 청구서 발송 배치 플랫폼

LG U+ 유레카 3기 종합 프로젝트 우수상

LG U+ 유레카 3기 종합 프로젝트로 백엔드 7명이 만들었고 우수상을 받았습니다. 매월 정해진 날 100만 명의 요금을 계산해 청구서를 보내야 하고, 작업이 중간에 멈추거나 같은 달을 다시 돌려도 정산이 중복 생성되면 안 됐습니다. 저는 기술팀장으로 정산 도메인 모델과 Job 설계, 배치 성능 개선을 맡았습니다.

기간
2026.01 – 2026.02, 재실행 검증은 2026.04 – 10 개인 후속 작업
역할
기술팀장, 정산 도메인 모델과 Job 설계, 배치 성능 개선 (백엔드 7명)
  • Java 17
  • Spring Batch
  • PostgreSQL
  • MongoDB
  • Grafana
정산 Job1의 Step 5개와 저장소, 작업(billing_work) 상태 변화. 강조색 P0–P4는 재실행 검증에서 장애를 넣는 지점입니다

주요 기여

Event Storming으로 Billing, Dispatch, Delivery 경계를 나누고 정산 Job의 Step을 설계했습니다. 작업 큐를 PostgreSQL로 옮기고 파티션 분배와 멀티스레드 적재로 계산 시간을 줄였습니다. 94가지 장애 시나리오로 재실행을 검증해 결함 7건을 고쳤습니다.

  • 108만 명 정산의 계산 단계를 팀원과 함께 10,120초 → 674초로 단축

    쿼리 지표로 느린 구간을 찾고, 파티션 분배와 작업 큐의 PostgreSQL 이전을 맡음

  • 작업 적재 단계 3,496초 → 29.5초, 다시 실행해도 같은 작업이 두 번 쌓이지 않음

    멀티스레드 처리와 중복을 건너뛰는 batch insert(ON CONFLICT DO NOTHING)로 교체

  • 정산 작업 큐의 dead tuple 12.48% → 0%, write 단계 peak time 9초 → 2.6초

    VACUUM (ANALYZE)로 쌓인 행을 정리하고, 테이블 단위 autovacuum 기준을 낮춰 다시 쌓이기 전에 정리되게 설계

  • 장애 지점 8곳과 종류 6개를 조합한 94가지 장애 시나리오로 재실행을 검증하고 결함 7건을 찾아 수정

    예외, 강제 종료, DB 연결 끊김과 timeout을 넣는 실행 스크립트와 Grafana 대시보드를 만들고, 건수 대신 사용자별 금액과 청구서 내용을 다시 계산해 대조

  • 재실행이 성공으로 끝나면서 1,000명을 청구하지 않던 결함을 찾아 수정

    한 번에 가져가는 작업 2,000건과 계산 단위 1,000건의 차이로 잠기는 작업을 돌려주고, 남은 작업이 있으면 월을 마감하지 않게 변경

TR1L / 설계와 성능01 / 02

중복 없는 정산 Job 설계와 계산 단계 2시간 49분 → 11분

중복 정산을 막는 요구사항을 Step마다 지킬 상태 규칙으로 정하고, 실행 기록을 비교해 가장 오래 걸리던 계산 단계를 줄였습니다.

01다시 돌려도 중복이 없도록 Step마다 지킬 규칙 정하기

문제
요구사항은 "특정일 전체 정산", "중복 정산과 중복 발송 금지" 같은 결과 조건뿐이었습니다. 어느 단계가 어떤 상태를 남기고 어디까지 실패를 허용할지는 없었습니다.
행동
팀과 Event Storming으로 남길 상태, 실패 지점, 중복 금지 대상을 먼저 정하고, 이를 도메인 모델과 Step별 상태 규칙에 반영했습니다. Step0이 cutoff를 고정해 끝난 월은 건너뛰고(PR #47), 12개 테이블 조인은 Step1에서 사용자당 1행으로 평탄화했습니다(ADR-0001, PR #67). 계산 결과는 MongoDB 스냅샷으로 고정해 청구서 Job은 조회만 합니다(ADR-0003).
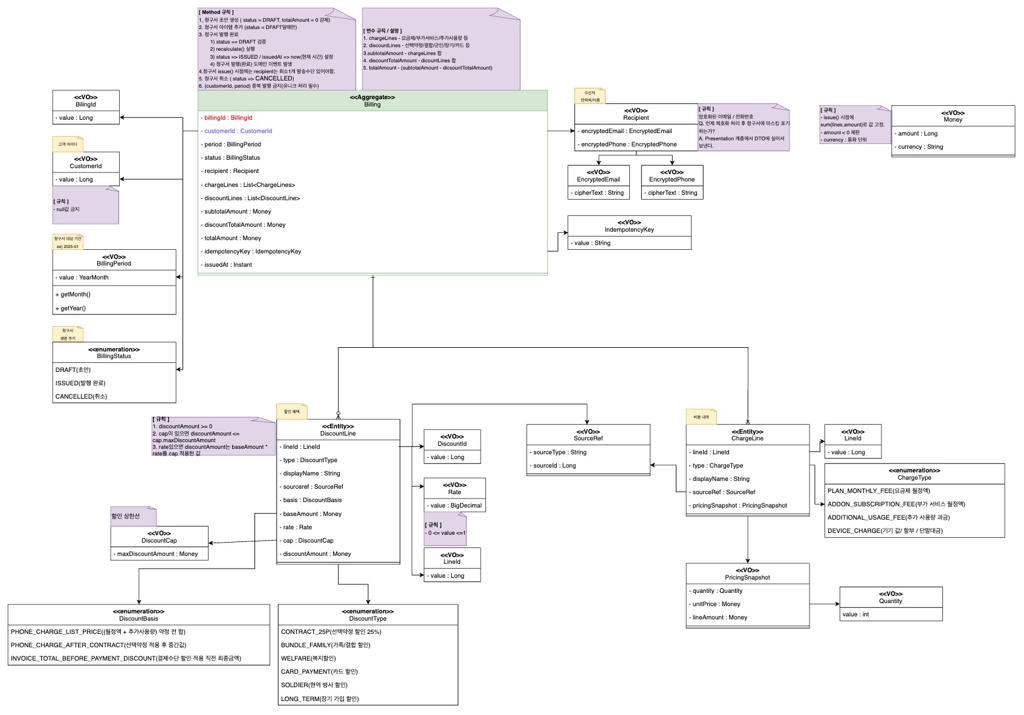
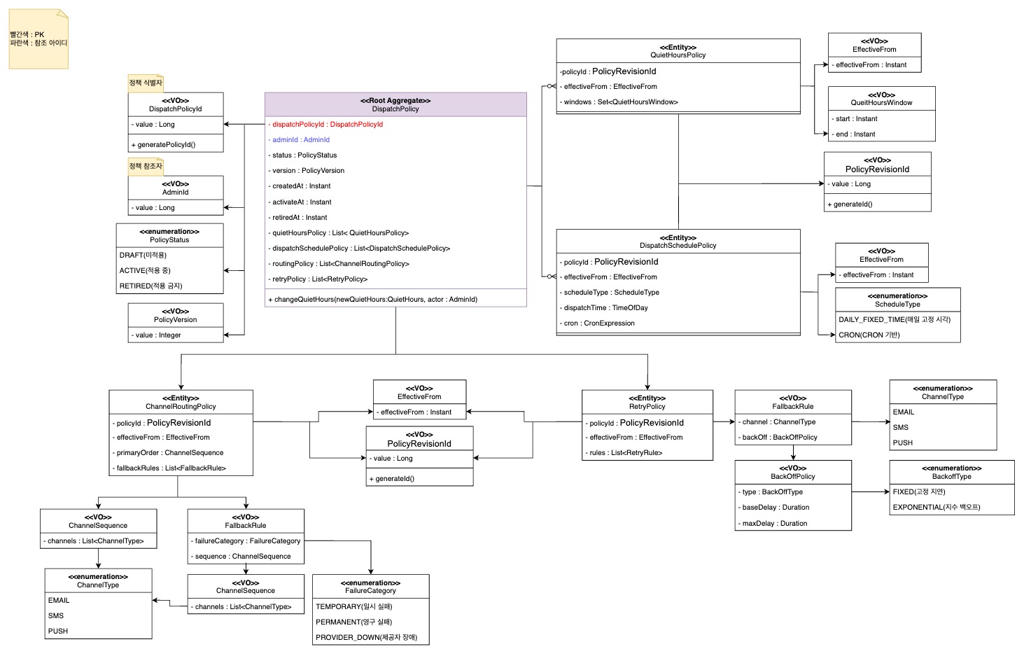
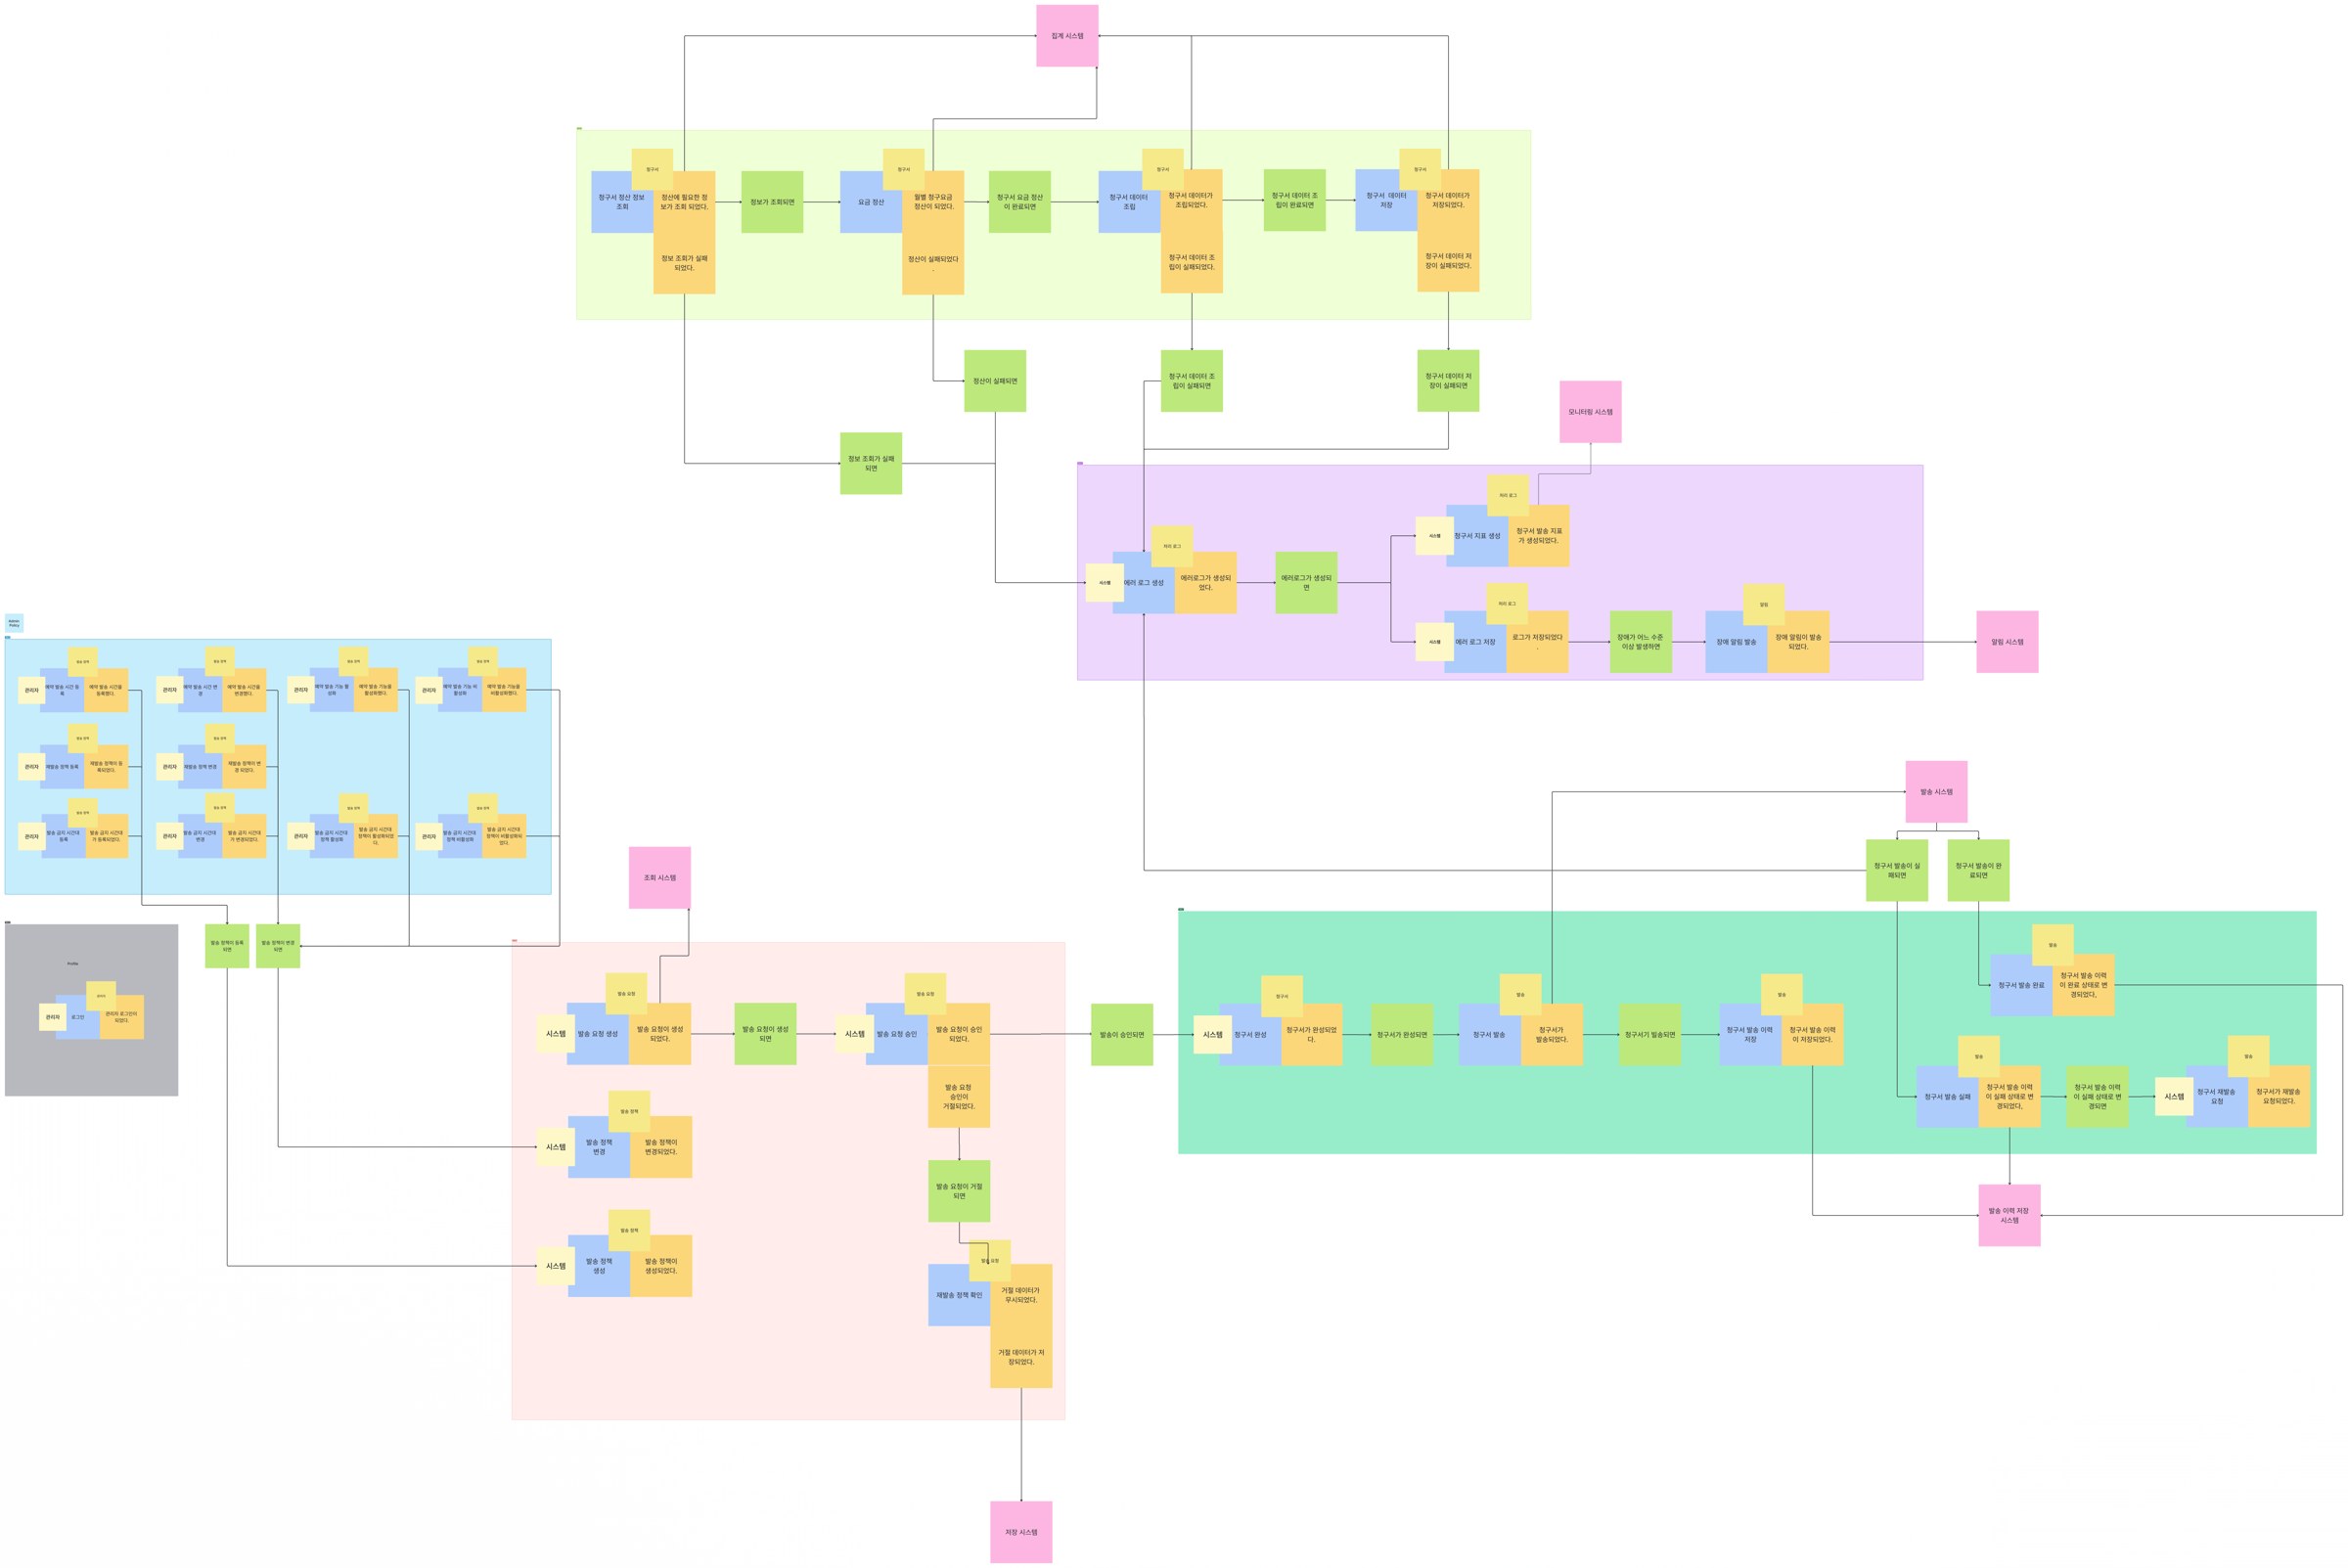
TR1L Event Storming 보드TR1L Billing 도메인 모델TR1L Dispatch 정책 도메인 모델
설계 산출물. Event Storming 보드, Billing 도메인 모델, 발송 정책 Dispatch 도메인 모델(누르면 원본)
결과
정산, 발송 정책, 전송을 세 Bounded Context로 나누고, Step0–4마다 다시 돌려도 결과가 같도록 지킬 조건을 정했습니다. 판단은 도메인 문서와 ADR 2건에 남겼습니다.
트레이드오프
평탄화 테이블은 쓰기 비용이 들고 스키마가 바뀌면 마이그레이션이 필요합니다. 결과 저장소가 하나 늘었습니다.
022시간 49분 걸리던 정산 계산 단계

문제
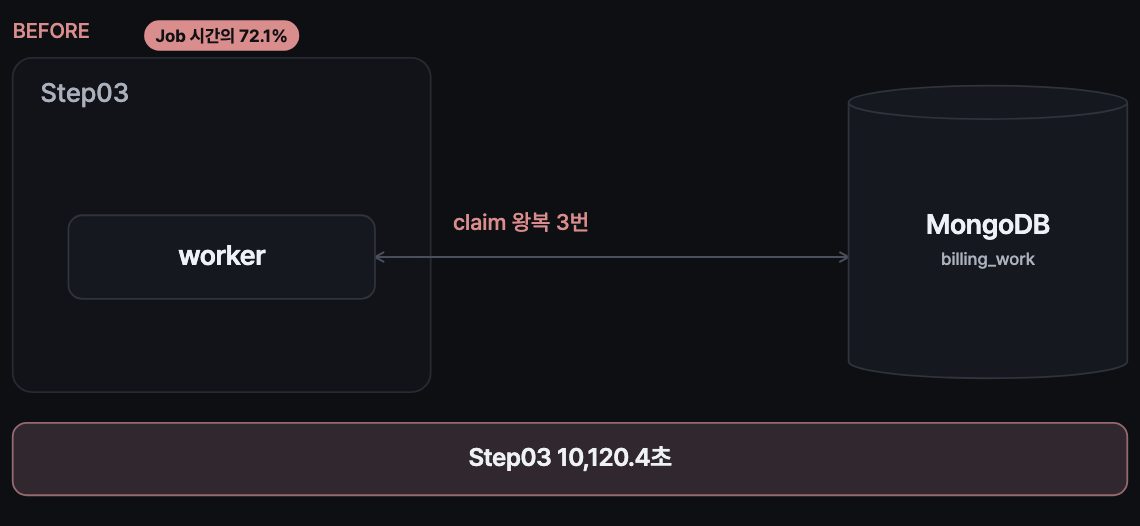
기준 실행에서 Job 14,038초 중 Step03이 10,120초로 72.1%였습니다. 스레드 수, 파티션 수, 작업 큐 저장소가 함께 바뀌어 변경마다 효과를 따로 확인해야 했습니다.
BEFORE. Step03 worker가 MongoDB 작업 큐와 claim을 세 번씩 오갑니다
행동
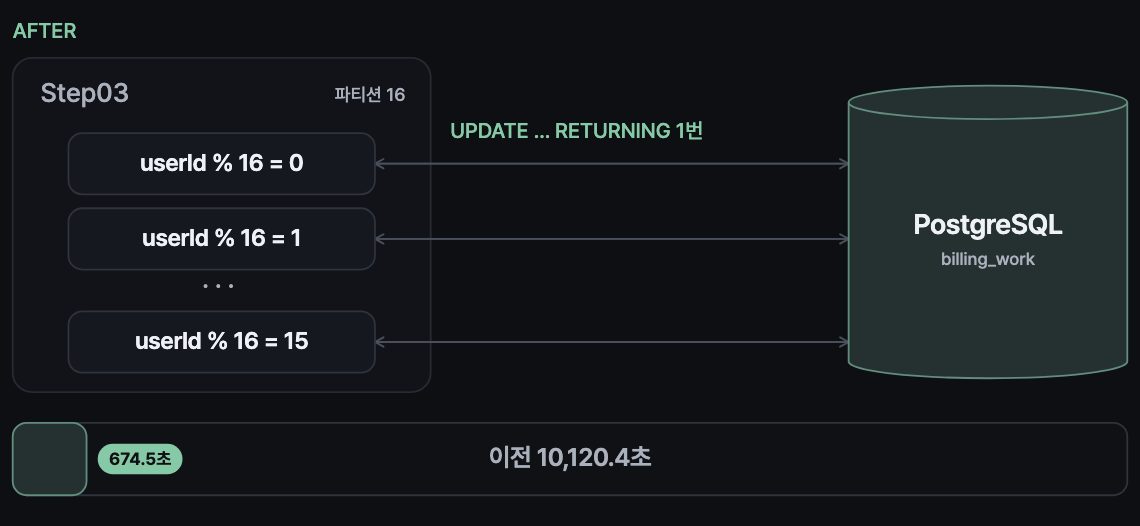
실행 기록을 변경 단위로 나눠 Step별 시간을 비교했습니다. Step02는 멱등 적재라 멀티스레드 Step을 걸었고(job 28에서 2.1배), Step03은 파티션마다 reader를 두고 userId 나머지로 후보를 나눠 파티션을 8개에서 16개로 늘렸습니다. 세 번 오가던 MongoDB claim은 큐를 PostgreSQL로 옮겨 UPDATE … RETURNING 한 번으로 줄였습니다.
결과
Step03 10,120.4초 → 674.5초, Step02 3,496.0초 → 29.5초 (108만 명, job 47).
AFTER. 16개 파티션이 PostgreSQL UPDATE … RETURNING 한 번으로 작업을 가져갑니다
실행들어간 변경Step02Step03
job 26기준. MongoDB 큐, 단일 스레드3,496.0초10,120.4초
job 28Step02 스레드 8, Step03 파티션 81,665.8초4,615.3초
job 43큐를 PostgreSQL로, 파티션 1629.3초633.7초
job 47같은 코드 재실행29.5초674.5초
트레이드오프
멀티스레드 Step은 처리 위치를 저장하지 않아, 다시 돌리면 처음부터 적재하고 이미 있는 행은 건너뜁니다. 상태 UPDATE가 몰려 dead tuple이 쌓입니다.
TR1L / 재실행 검증02 / 02

재실행이 성공으로 끝났는데 1,000명이 빠져 있었습니다

배치 실행 중 여러 지점에 장애를 넣고 재실행 결과를 정상 실행과 비교했습니다. 94가지 장애 시나리오에서 결함 7건을 찾아 고쳤습니다.

0394가지 장애 시나리오로 찾은 결함 7건

결함영향수정
1중간 chunk 실패 뒤 재실행1,000명 미청구, 종료 코드 0실패 작업 반환, 남은 작업 있으면 마감 보류
2Step0 실패다음 Step이 그대로 진행Step0 실패 시 Job 중단
3108만 명에서 옵션 조회같은 입력에 다른 청구서조회 순서 고정
4계산 Job 강제 종료 뒤 재실행시작 안 하고 종료 코드 0실행마다 새로 시작, 실패 시 종료 코드 2
5재실행 사이 원천 데이터 변경같은 달 청구 기준이 섞임첫 실행 때 청구 대상과 값 고정
6MongoDB 무응답worker가 끝나지 않음MongoDB 읽기 timeout 120초
7청구서 Job 강제 종료 뒤 재실행15,000/28,500건에서 멈춤멈춘 지점부터 이어서 재시작
문제
정산 배치는 중간에 멈춘 뒤 다시 돌려도 누락이나 중복 없이 같은 금액이 나와야 합니다. 이를 확인하려면 장애가 나는 위치와 종류를 바꿔 가며 건수뿐 아니라 금액까지 비교해야 했습니다.
행동
장애 지점 8곳, 시점 3개(첫, 중간, 마지막 chunk), 종류 6개(예외, 강제 종료, PostgreSQL 끊김, MongoDB 끊김, MongoDB timeout, worker 2개 동시 실행)를 조합하고, Step 특성상 의미 없는 조합을 빼 94가지 장애 시나리오를 만들었습니다(PR #371, #379, #391). 시나리오마다 사용자별 금액과 청구서 내용을 정상 실행과 비교했습니다.
장애 시나리오 구성. 시나리오마다 정상 실행, 장애 실행, 같은 cutoff 재실행을 거쳐 정산 결과를 비교합니다
결과
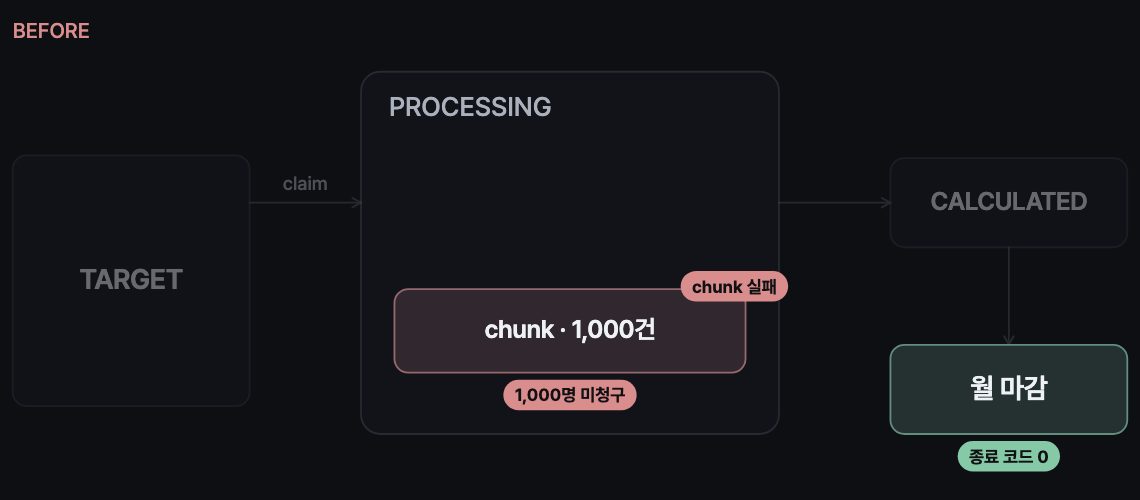
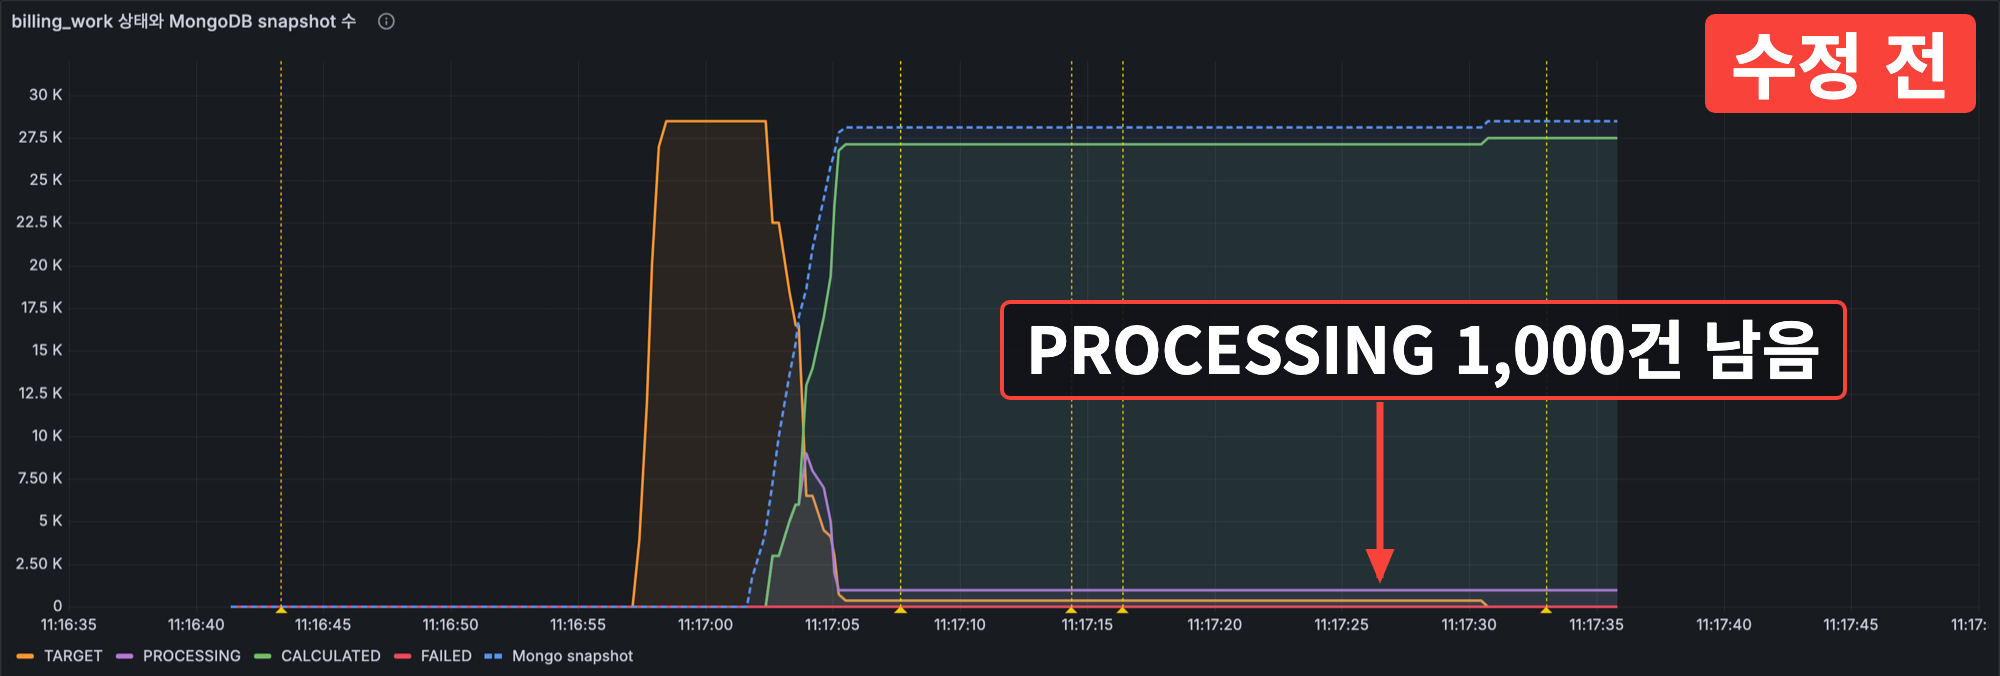
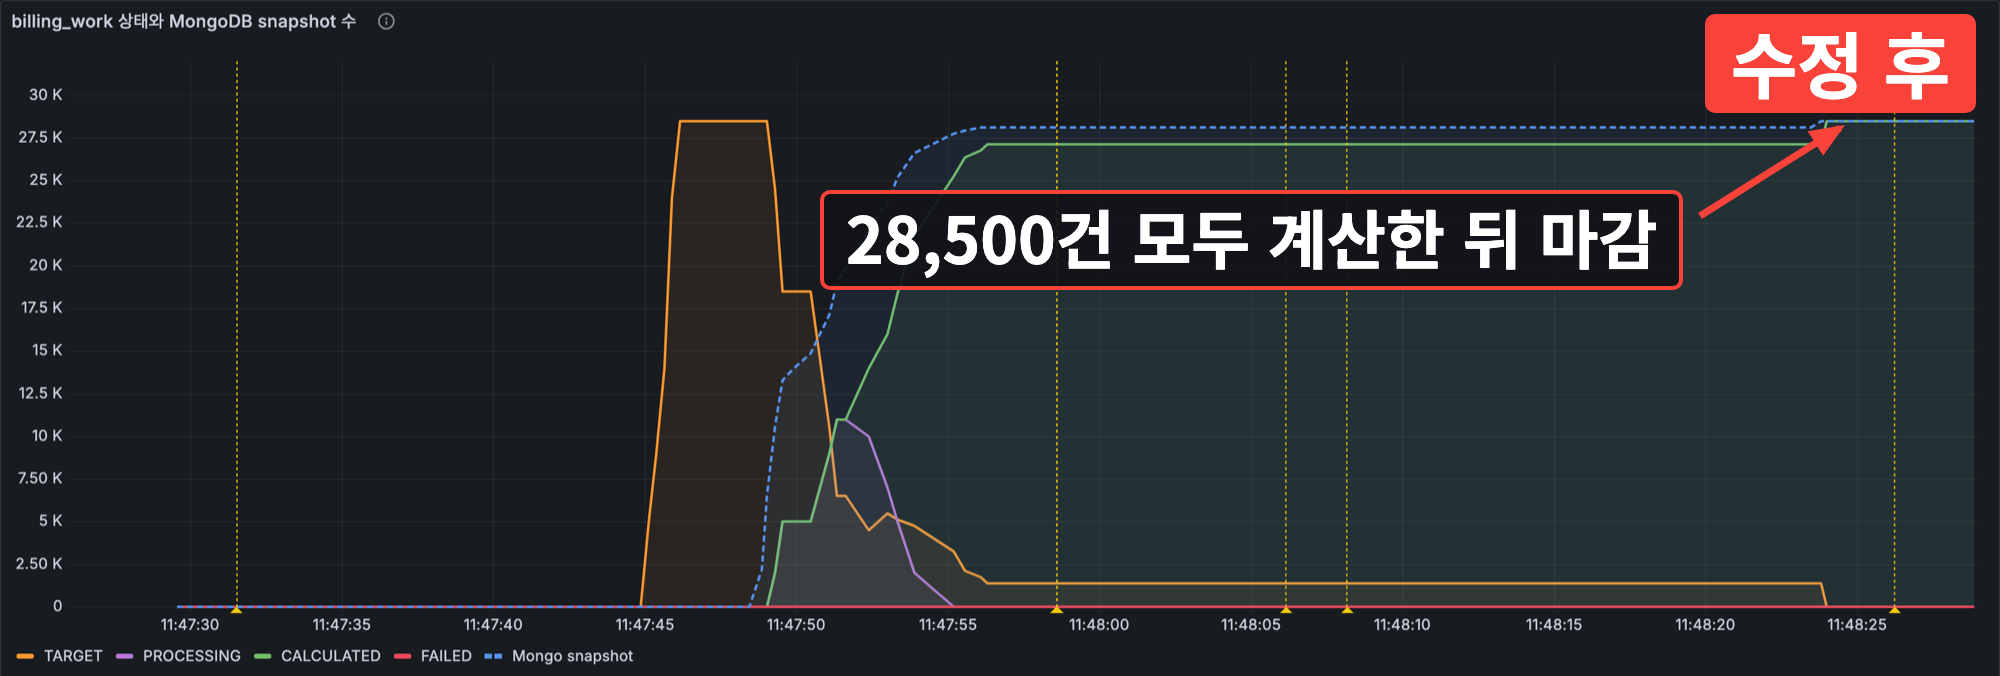
결함 1은 1,000명이 청구되지 않았는데 종료 코드가 0이었고, 월이 마감돼 다시 돌려도 복구되지 않았습니다. 결함 7은 결함 4처럼 고치면 이미 보낸 청구서를 다시 보내게 돼, 멈춘 지점부터 이어서 돌도록 따로 고쳤습니다. 7건을 고친 뒤 같은 시나리오를 다시 돌려 확인했습니다.
BEFORE. 2,000건을 가져가 1,000건 단위로 계산하다 한 chunk가 실패하면, 1,000건이 PROCESSING에 남은 채 월이 마감됩니다
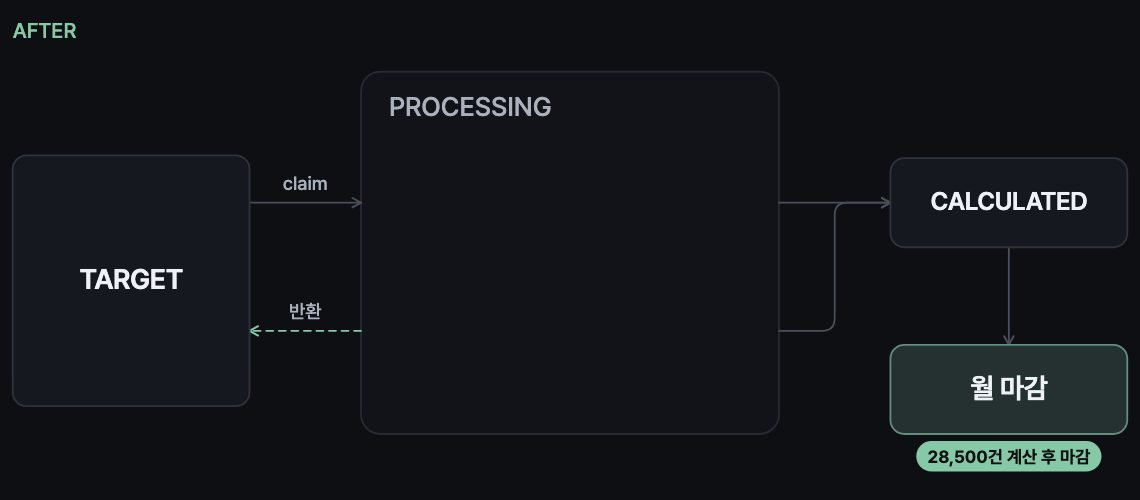
AFTER. 실패한 작업을 돌려주고, 남은 작업이 있으면 마감을 미룹니다
결함 1 수정 전 Grafana 화면, PROCESSING 1,000건이 남은 채 마감결함 1 수정 후 Grafana 화면, 28,500건을 모두 계산한 뒤 마감
실제 Grafana 화면. 수정 전(왼쪽)에는 PROCESSING 1,000건이 남은 채 마감됐고, 수정 후(오른쪽)에는 28,500건을 모두 계산한 뒤 마감됩니다
검증
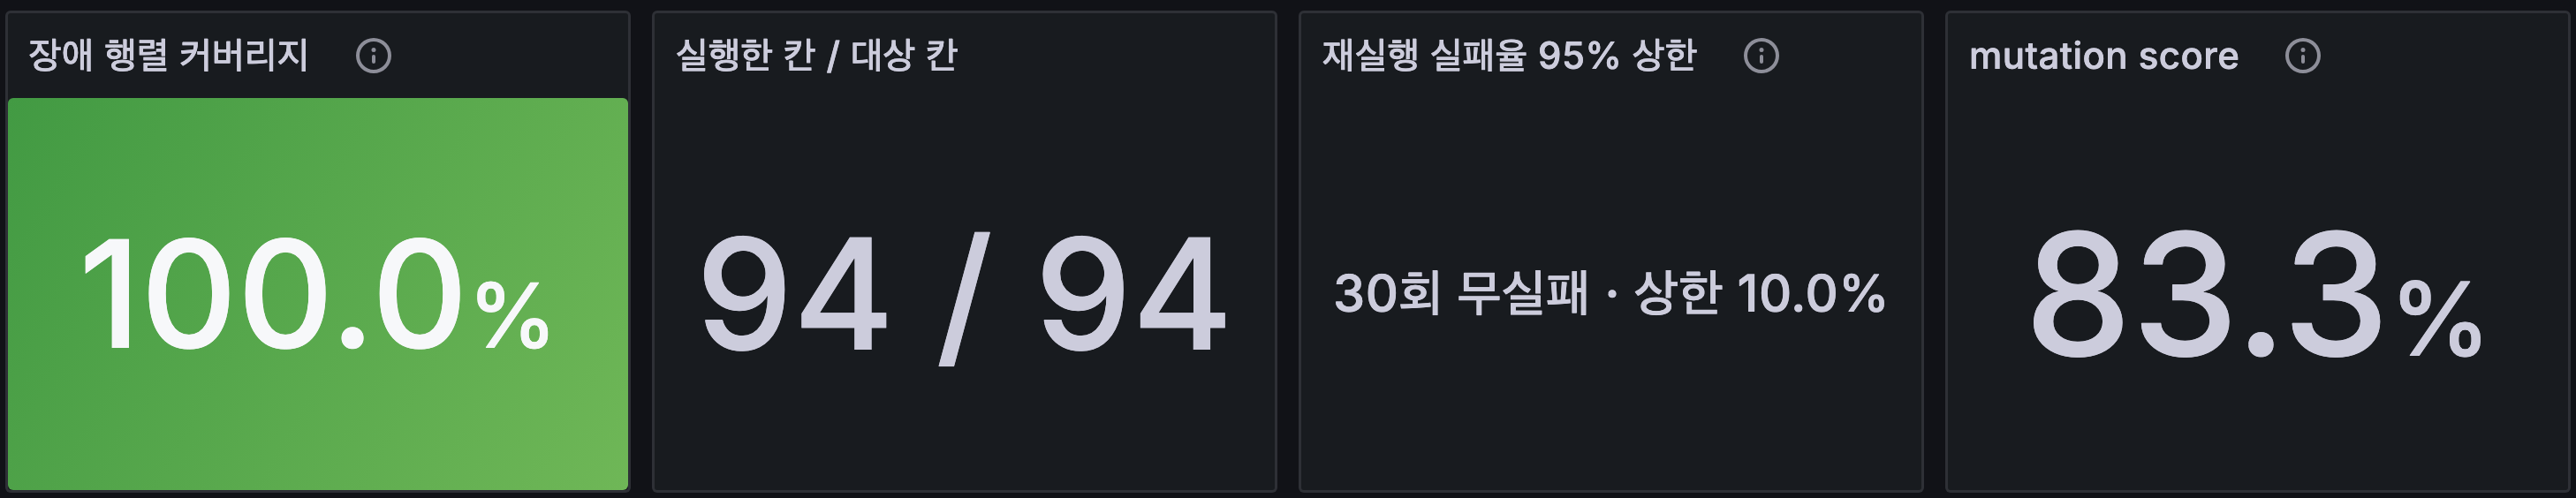
테스트가 실제 결함을 잡는지도 확인했습니다. 코드 6곳에 일부러 버그를 넣고 같은 시나리오를 돌리자 5곳을 찾아냈습니다. 예를 들어 약정 할인을 내림 대신 올림으로 계산하게 바꾸자 1,026명의 청구 금액이 1원씩 달라졌습니다. 처리 건수는 그대로라 건수 테스트는 통과했고, 직접 추가한 금액과 청구서 내용 비교 테스트에서만 드러났습니다.
재실행 검증 Grafana 요약 패널
재실행 검증 대시보드 요약. 94개 시나리오를 모두 실행했고(94/94), 일부러 넣은 버그 6곳 중 5곳을 찾았습니다(mutation score 83.3%)

PROJECT 02 / HOLLIVERSE

Holliverse

고객 데이터 기반 통신 서비스 분석과 개인별 추천 플랫폼

LG U+ 유레카 3기 최종 융합 프로젝트 우수상

LG U+ 유레카 3기 최종 융합 프로젝트로 7명(백엔드 4, 프론트 3)이 만들었고 우수상을 받았습니다. 상담 분석, 행동 로그 수집, 개인별 추천, 이탈률 계산을 한 플랫폼에 담았습니다. 저는 기술팀장으로 AWS 인프라를 설계하고 구축했고 이탈률 설계와 로그 파이프라인을 맡았습니다.

기간
2026.01 – 2026.03, 로그 유실 추적은 수상 뒤 03.28 – 04.03
역할
기술팀장, 인프라 전담, 이탈률 설계와 로그 파이프라인 (7명: 백엔드 4, 프론트 3)
  • Java 17
  • Spring Boot
  • PostgreSQL
  • AWS ECS
  • AWS CDK(Java)
  • Kafka(MSK)
  • FastAPI
  • Grafana
  • k6
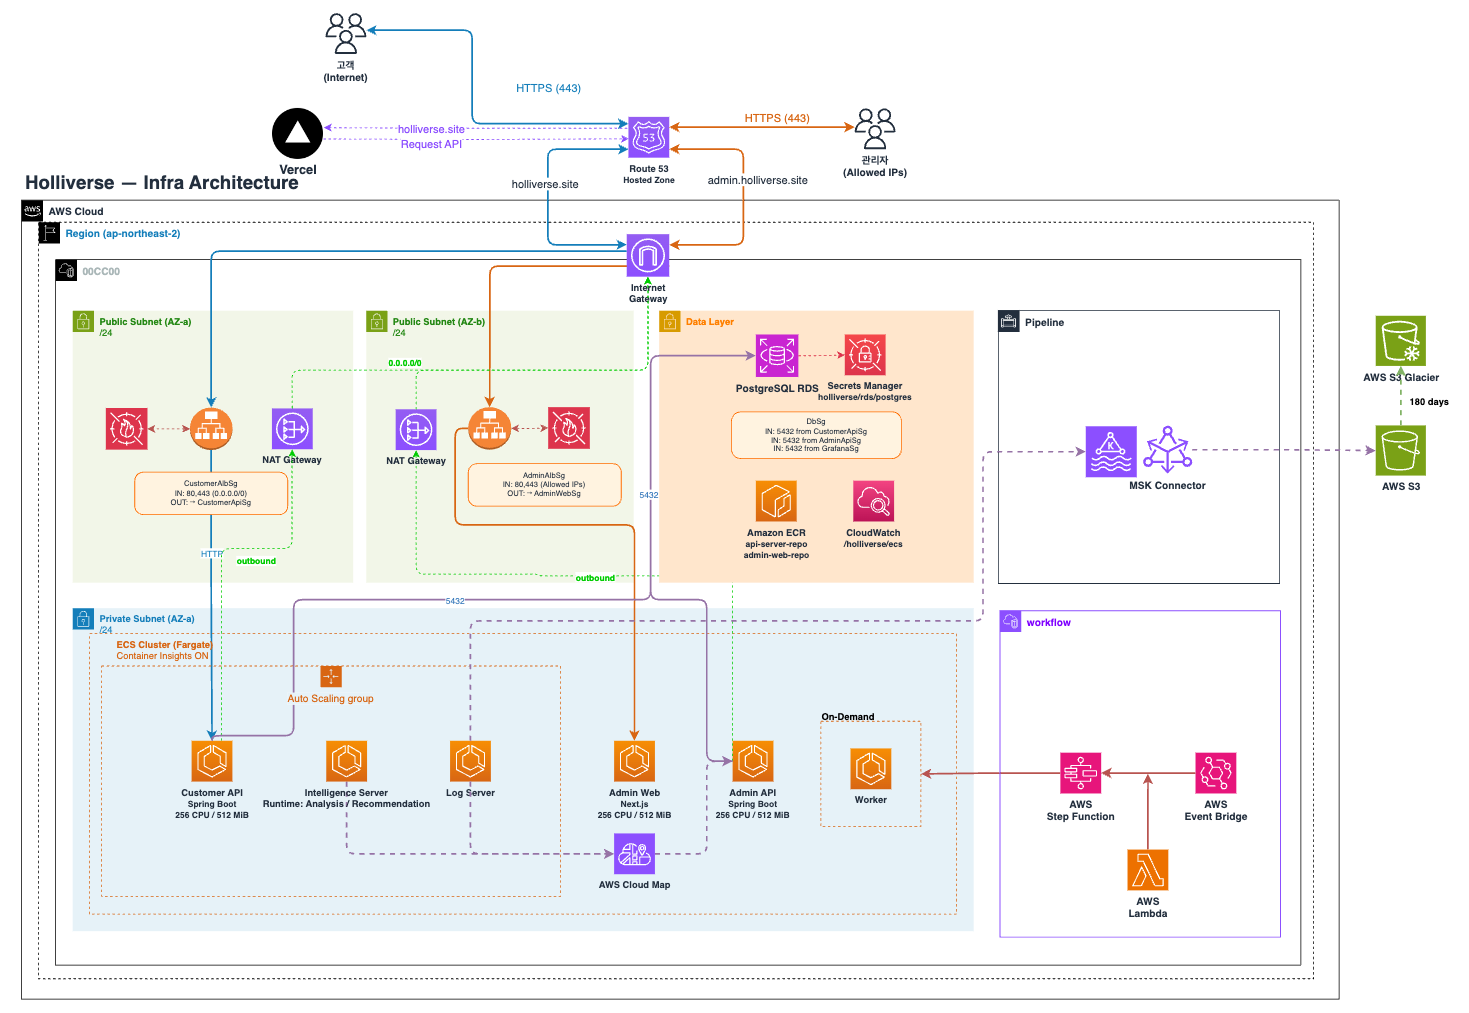
Holliverse AWS 인프라 구성도
Holliverse AWS 인프라. 서비스 5개는 ECS Fargate, 사용자 로그는 MSK Connector로 S3에 쌓고 Worker는 Step Functions로 필요할 때만 실행합니다

주요 기여

로그 전달 경로의 유실 원인 추적, Java CDK 15개 스택 설계와 task definition 롤아웃으로 서비스 배포 시간 50.9% 단축, 부하 시험에서 포화된 관리자 API의 용량과 Auto Scaling 조정

  • 응답은 성공인데 분석 DB에서 빠지던 행동 로그를 추적해 21,526건 전 구간 일치

    구간별 건수를 세어 ECS 환경변수가 커넥션 풀을 50에서 10으로 덮어쓴 원인을 찾음

  • 이미지 하나만 바꿔도 스택 전체를 재배포하던 방식을 task definition 롤아웃으로 분리

    AWS CDK(Java) 15개 스택으로 인프라 저장소를 전담

  • 부하 시험 30초 만에 멈춘 관리자 API의 CPU 사용률을 99.4% → 최대 16%로 낮춤

    CPU 포화로 진단하고 task 자원 확장과 Target Tracking 오토스케일을 적용

  • S3 Lifecycle로 장기 로그 보관 비용을 연 $1.59k → $0.42k로 낮춤 (추산)

    DAU 3만, 1인당 하루 500KB로 산정하고 30일 IA, 90일 Glacier IR, 180일 Deep Archive, 365일 만료로 나눔

  • 상담 분석과 행동 로그를 반영하는 이탈 점수 엔진과 실시간 위험도 조회 API 구현

    계약, 사용량, 행동, 상담 불만을 항목별 규칙으로 점수화하고, 관리자 화면에는 점수가 바뀐 고객만 커서로 전달

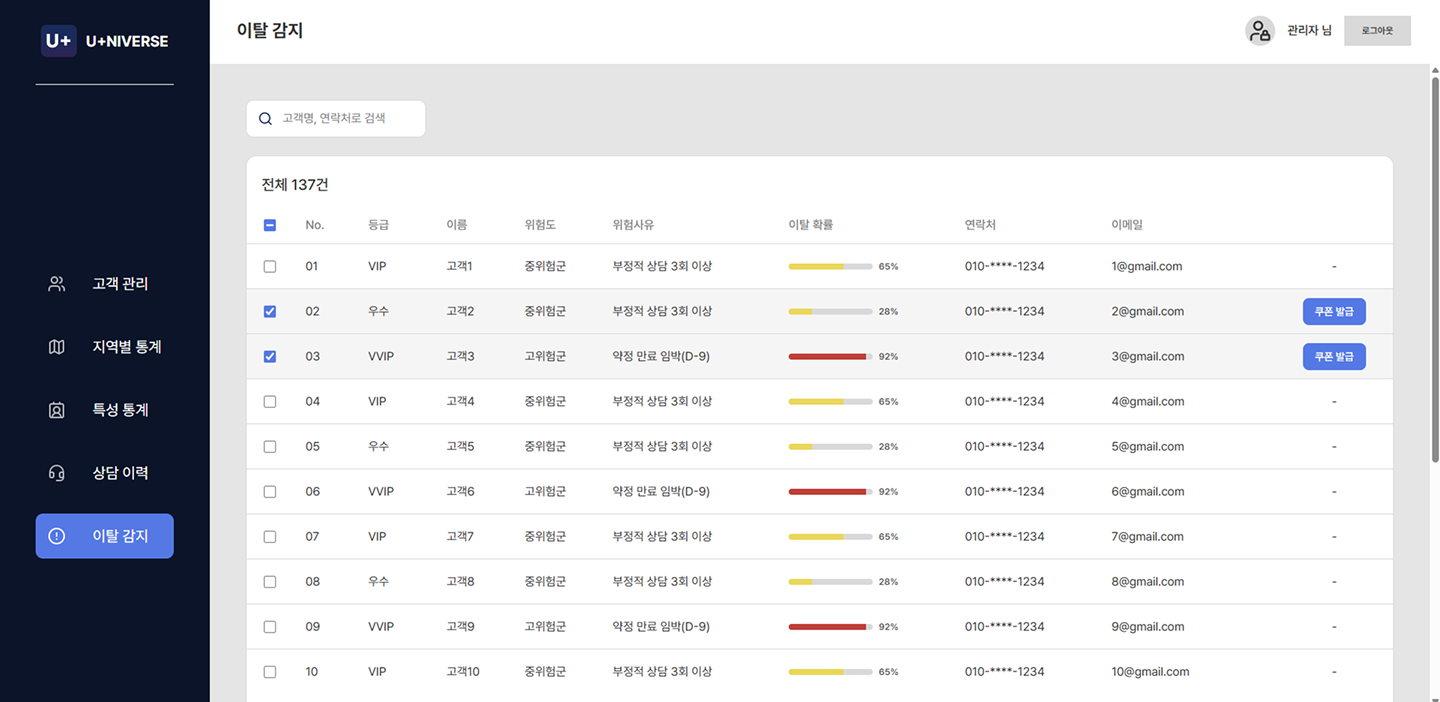
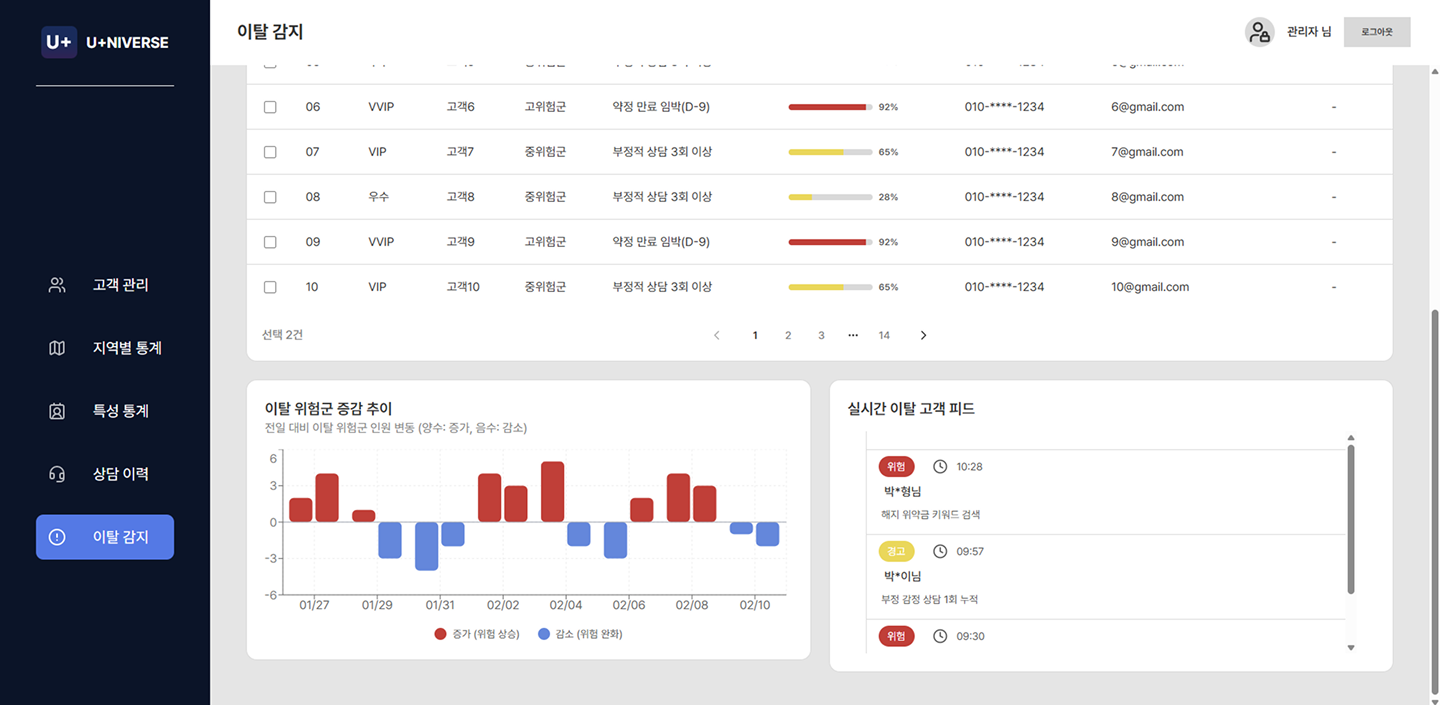
    Holliverse 관리자 이탈 감지 화면 1Holliverse 관리자 이탈 감지 화면 2
    이탈 점수를 쓰는 관리자 화면
  • Python(FastAPI) 분석 서버의 Kafka 소비 파이프라인과 배포 구성을 맡음

    REST와 EFS 기반 경로를 Kafka 소비 방식으로 바꾸고 MSK IAM 인증, 실시간과 배치 실행 모드를 나눔

HOLLIVERSE / 로그 파이프라인01 / 02

수락된 행동 로그 일부가 분석 DB에 없던 문제

응답은 모두 202였는데 Feature DB에는 일부가 없었습니다. 전달 경로를 만든 제가 원인을 좁혔습니다.

01응답 성공과 데이터 도착은 다릅니다

문제
로그 API는 202로 받은 뒤 이탈률 계산용 로그를 비동기로 Admin Server에 넘깁니다. 첫 시험에서 26.87%가 Feature DB에 없었고 어디서 사라지는지 보이지 않았습니다.
행동
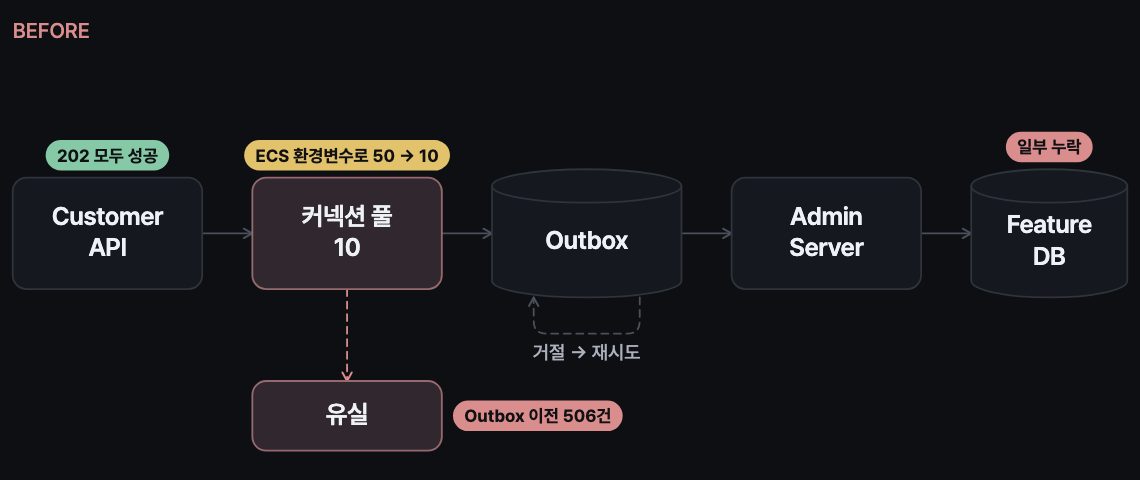
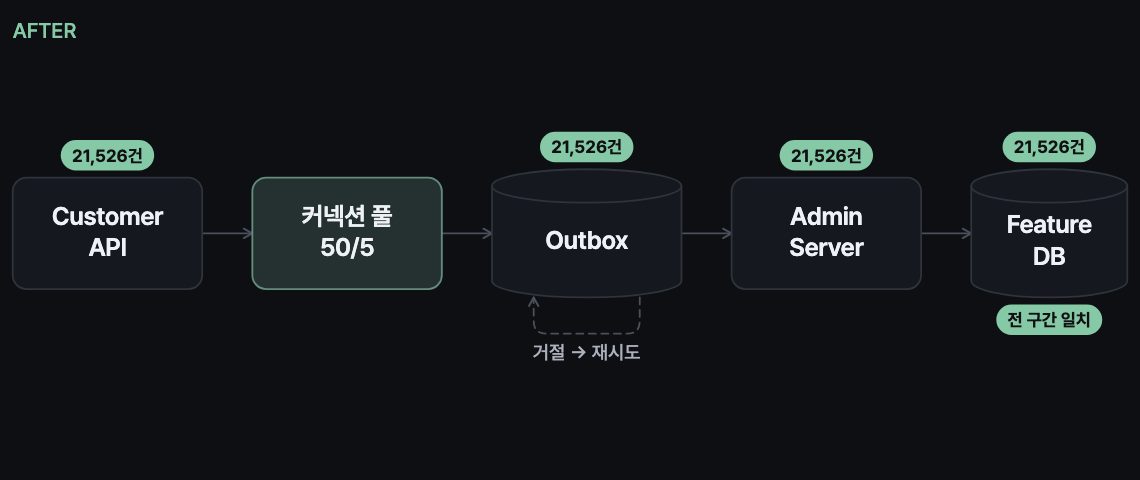
구간마다 지표를 넣고 하나씩 바꿔 가며 쟀습니다. executor 분리, 거절 정책 변경, Outbox 재전달을 거쳐도 2.91%가 남았고 5분 뒤에도 그대로라 지연이 아닌 유실이었습니다. 구간별 건수를 세어 Outbox 이전에 506건이 사라진 것을 찾았고, 원인은 ECS 환경변수가 커넥션 풀 50을 10으로 덮어쓴 것이었습니다.

문제를 좁혀 간 과정

단계해 본 것관측판단
1지표 추가, executor 분리누락 26.87% → 13.24%, 다시 포화포화 때 전달이 user-log 스레드로
2거절 정책을 AbortPolicy로p95는 줄고 누락 50.64%거절된 로그를 남길 곳이 필요
3Outbox 적재와 묶음 전달2.91% 남음5분 뒤에도 그대로라 유실
4구간별 건수 계측Outbox 이전 506건 손실, 풀 실효값 10ECS 환경변수가 secret 50을 덮어씀
Outbox 도입 전후 요청 경로. 전에는 관리자 서버 호출이 로그 요청 경로 안에 묶여 있었고, 후에는 Outbox 적재로 경계를 나눴습니다
BEFORE. 202 응답은 모두 성공했지만, 실효값이 10이던 커넥션 풀에서 Outbox 이전 506건이 사라졌습니다
결과
풀을 50/5로 바로잡은 최종 시험에서 21,526건이 전 구간 일치했습니다. 거절된 로그는 Outbox 행으로 남겨 재시도합니다(PR #277, PR #278, PR #284).
AFTER. 커넥션 풀을 50/5로 바로잡은 뒤 21,526건이 전 구간 일치했습니다
트레이드오프
Outbox는 저장 비용과 반영 지연이 생깁니다. 묶음이 실패하면 묶음 전체를 다시 보냅니다.

HOLLIVERSE / 인프라02 / 02

배포 경로와 관리자 API 용량

이미지만 바꿀 때도 CDK 배포를 거치던 경로를 줄이고, 부하 시험에서 포화된 컨테이너 용량을 조정했습니다.

02서비스 이미지 교체에도 CDK 배포가 필요했던 파이프라인

문제
인프라는 Java CDK 15개 스택입니다. 서비스 이미지 하나만 바뀌어도 cdk deploy로 CloudFormation 스택을 갱신해야 했습니다. 스택 단위로 나눈 뒤에도(PR #22) 이미지 교체는 같은 경로였습니다.
행동
이미지 교체에는 새 이미지를 가리키는 task definition 등록만 있으면 된다고 보고, 서비스 배포 파이프라인에서 cdk deploy를 뺐습니다. 실행 중인 정의를 복사해 이미지 주소만 바꿔 등록하고 services-stable을 기다립니다. 모니터링 스택도 따로 배포하게 했습니다.
서비스 배포 경로 전후. cdk deploy와 CloudFormation 갱신 대신 실행 중인 task definition을 복사해 이미지만 바꿔 등록합니다
결과
서비스 배포 중앙값 449.1초 → 220.4초(50.9%), 모니터링 배포 449.1초 → 82.7초. CloudFormation 갱신과 ECS 안정화 이벤트 시각으로 쟀습니다.
트레이드오프
런타임 설정과 CDK 코드의 차이가 쌓입니다.

03부하 시험 30초 만에 포화된 관리자 API

문제
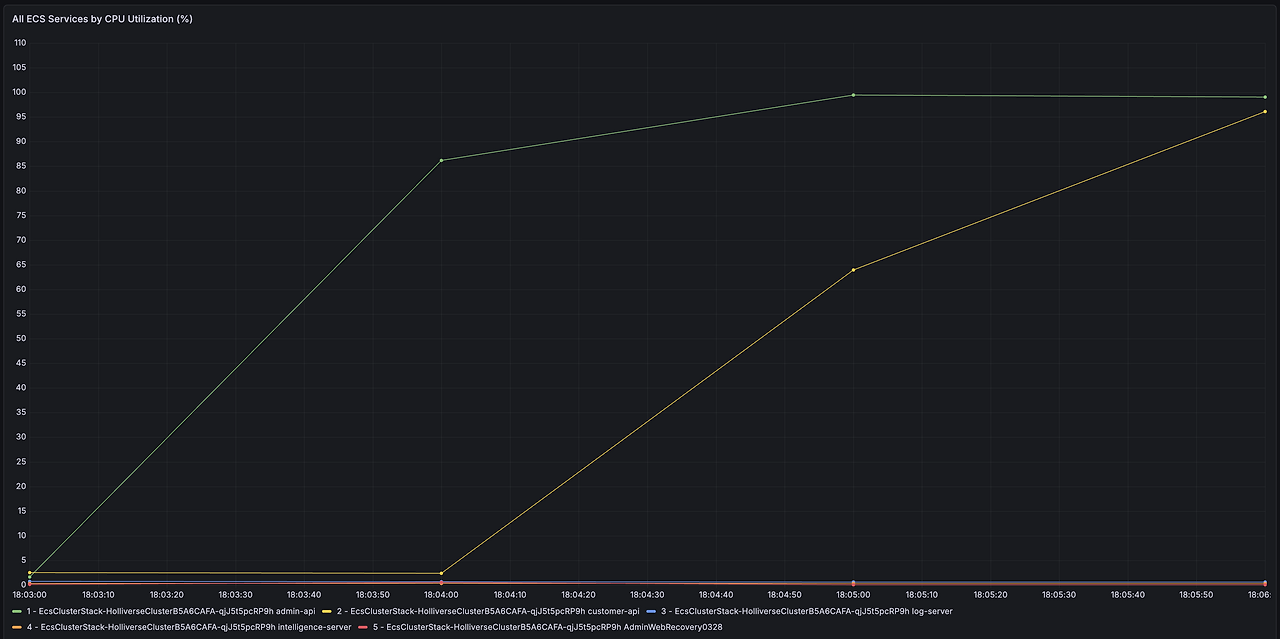
팀원이 만든 k6 시나리오(관리자 50명, API 9개)가 30초를 버티지 못했고 CPU 사용률은 99.4%였습니다.
행동
절대치를 보니 CPU units 254/256, 메모리 99.4%였고 Running 1, Pending 0이었습니다. CDK가 256/512와 desiredCount 1로 고정해 Auto Scaling이 없었습니다. task를 512/1,024MiB, 최소 2개로 올리고 CPU 65%와 메모리 75% 기준 Target Tracking(최대 4개)을 걸었습니다. 메모리도 한계까지 찼기 때문에 CPU와 따로 메모리 기준을 뒀습니다.
결과
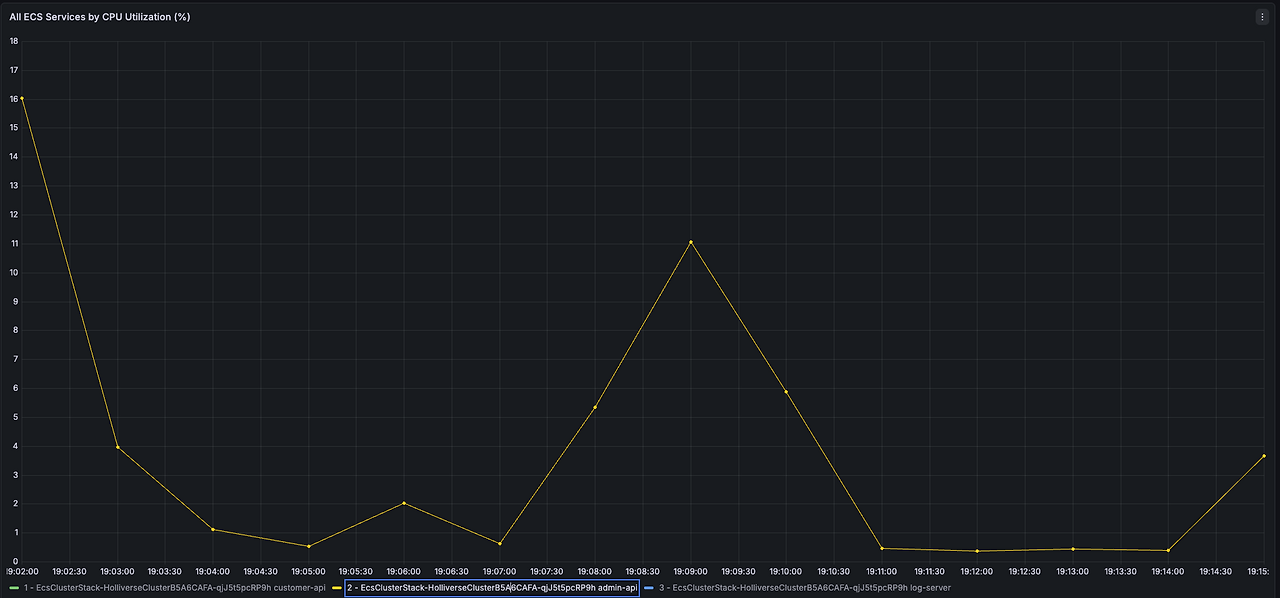
부하가 걸리자 task가 2개에서 4개로 늘었고, CPU 사용률은 최대 99.4%에서 16%로 내려갔습니다.
admin-api CPU 사용률, 조정 전 Grafana 화면admin-api CPU 사용률, 조정 후 Grafana 화면
admin-api CPU 사용률, 조정 전(왼쪽)과 조정 후(오른쪽)

PROJECT 03 / QELLO

Qello

방향과 위치 기반 주변 사용자 소통 서비스

기간
2026.07 – 진행 중
소속
DND 15기 사이드 프로젝트, 6명(디자인 2, 백엔드 2, 프론트 2)
역할
백엔드. 콘텐츠 검수, 회의록 자동화, AI 개발 환경과 CI 담당
  • Spring Boot
  • PostGIS
  • n8n
  • Discord
  • ClickUp
  • Docker Compose
  • Claude Code
  • GitHub Actions
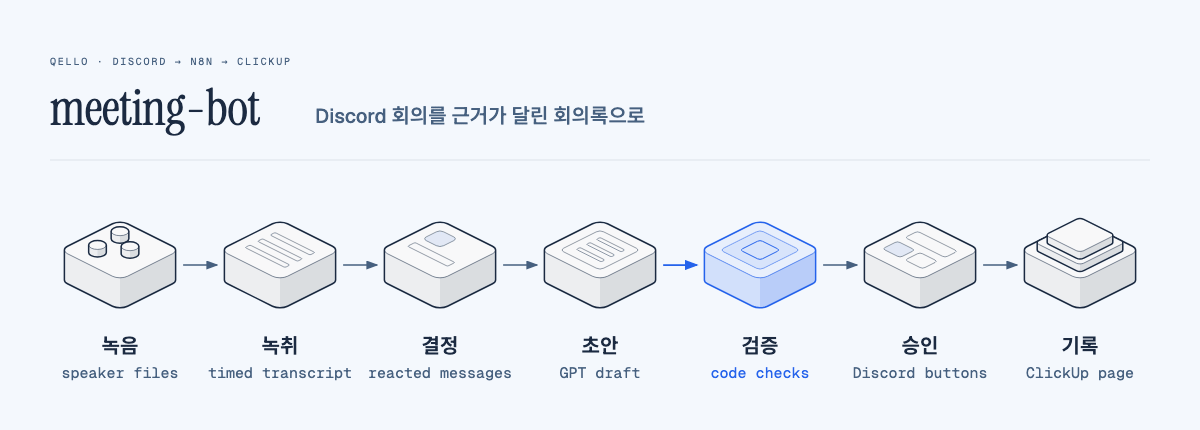
회의록 자동화 meeting-bot 흐름도
회의록 자동화 흐름. 녹음, 녹취, 결정 수집, 초안, 검증, 승인, ClickUp 기록

주요 기여

  • 닉네임과 답변의 콘텐츠 검수 파이프라인 구현

    로컬 규칙과 OpenAI Moderation으로 판정하고, 호출이 실패하면 닉네임은 막고 답변은 재시도 뒤 수동 검토로 넘김

  • Discord 녹음 봇과 n8n으로 회의록 자동화, 작성 시간 10~15분 → 3분 이내

    gpt-4o-transcribe 녹취, LLM 초안, Code 노드 근거 검증, Discord 버튼 승인을 거쳐 ClickUp에 기록하고 서버에 배포

  • Claude Code와 Codex가 같은 AGENTS.md를 읽게 하고, 판정할 수 있는 규칙은 문서 대신 검사로 강제

    금지 명령은 permissions.deny 14개로, 브랜치와 커밋 형식, secret은 Git 훅 4종과 검증기 8종으로 막음

    AI 개발 환경 하네스. Claude Code와 Codex가 같은 AGENTS.md를 읽고, 규칙은 Git 훅과 검증기로 강제합니다
  • PR 검증 CI의 test job 822초 → 348초

    클래스마다 띄우던 PostGIS 컨테이너와 Spring 컨텍스트를 공유하고, 같은 커밋 10회씩 비교해 줄었을 때만 병합

QELLO / 회의록 자동화01 / 01

회의록 자동화

Discord 회의 녹음부터 ClickUp 기록까지 n8n 워크플로로 옮겼습니다. LLM은 회의록 초안만 쓰고, 근거 검증과 최종 기록은 코드와 팀원 승인이 맡습니다

DND 15기 Qello 팀은 Discord에서 일주일에 두 번 회의합니다. 회의록을 ClickUp 템플릿에 옮기는 데 한 편에 10~15분이 걸렸고, 채팅으로 정한 결정은 빠지곤 했습니다. 지금은 /회의녹음 종료 한 번으로 녹취, 결정 수집, 초안, 근거 검증을 거쳐 승인한 초안만 ClickUp에 기록합니다. Oracle Cloud A1 서버에 Docker Compose로 배포해 쓰고 있습니다.

기간
2026.07.06 – 진행 중
역할
회의록 자동화 설계, 구현, 서버 운영

01LLM 도구를 고른 기준과 측정한 결과

실행 방식
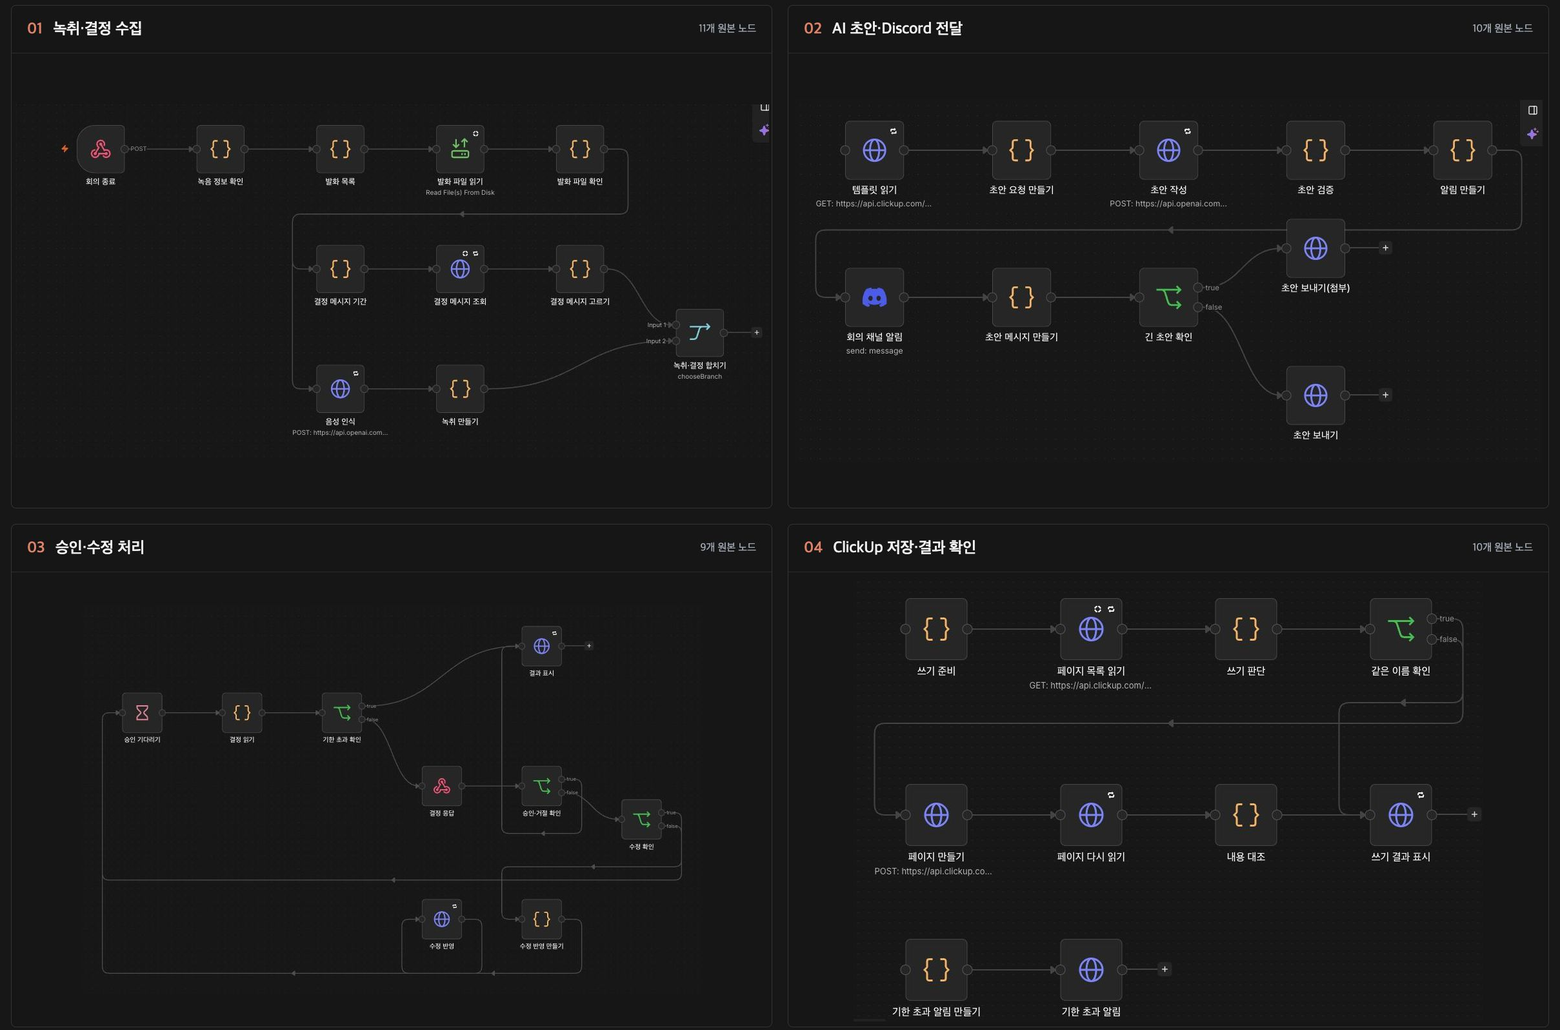
순서가 고정된 일이라 에이전트 대신 n8n 워크플로로 만들었습니다. 노드 40개(녹취와 결정 수집 11, 초안과 전달 10, 승인과 수정 9, 저장과 대조 10)와 실패 알림 워크플로를 둡니다.
회의록 자동화 n8n 워크플로 화면
n8n 노드 40개. 녹취와 결정 수집, 초안 작성과 전달, 승인과 수정, ClickUp 저장과 대조
초안 모델
Claude Sonnet 5.5(회의당 약 $0.15), gpt-6-astra, gpt-6.1-sol과 공시 단가를 비교해 gpt-6-luna(회의당 약 $0.02, 추정)를 골랐습니다. 형식이나 근거가 틀린 초안은 뒤의 Code 노드가 멈춥니다.
음성 인식
n8n 기본 OpenAI 노드는 whisper-1로 고정돼 HTTP Request + gpt-4o-transcribe로 바꿨습니다. 같은 1분 녹음에서 16.6초 대 3.0초, 지어낸 문구 1줄 대 0줄이었습니다.
근거 검증
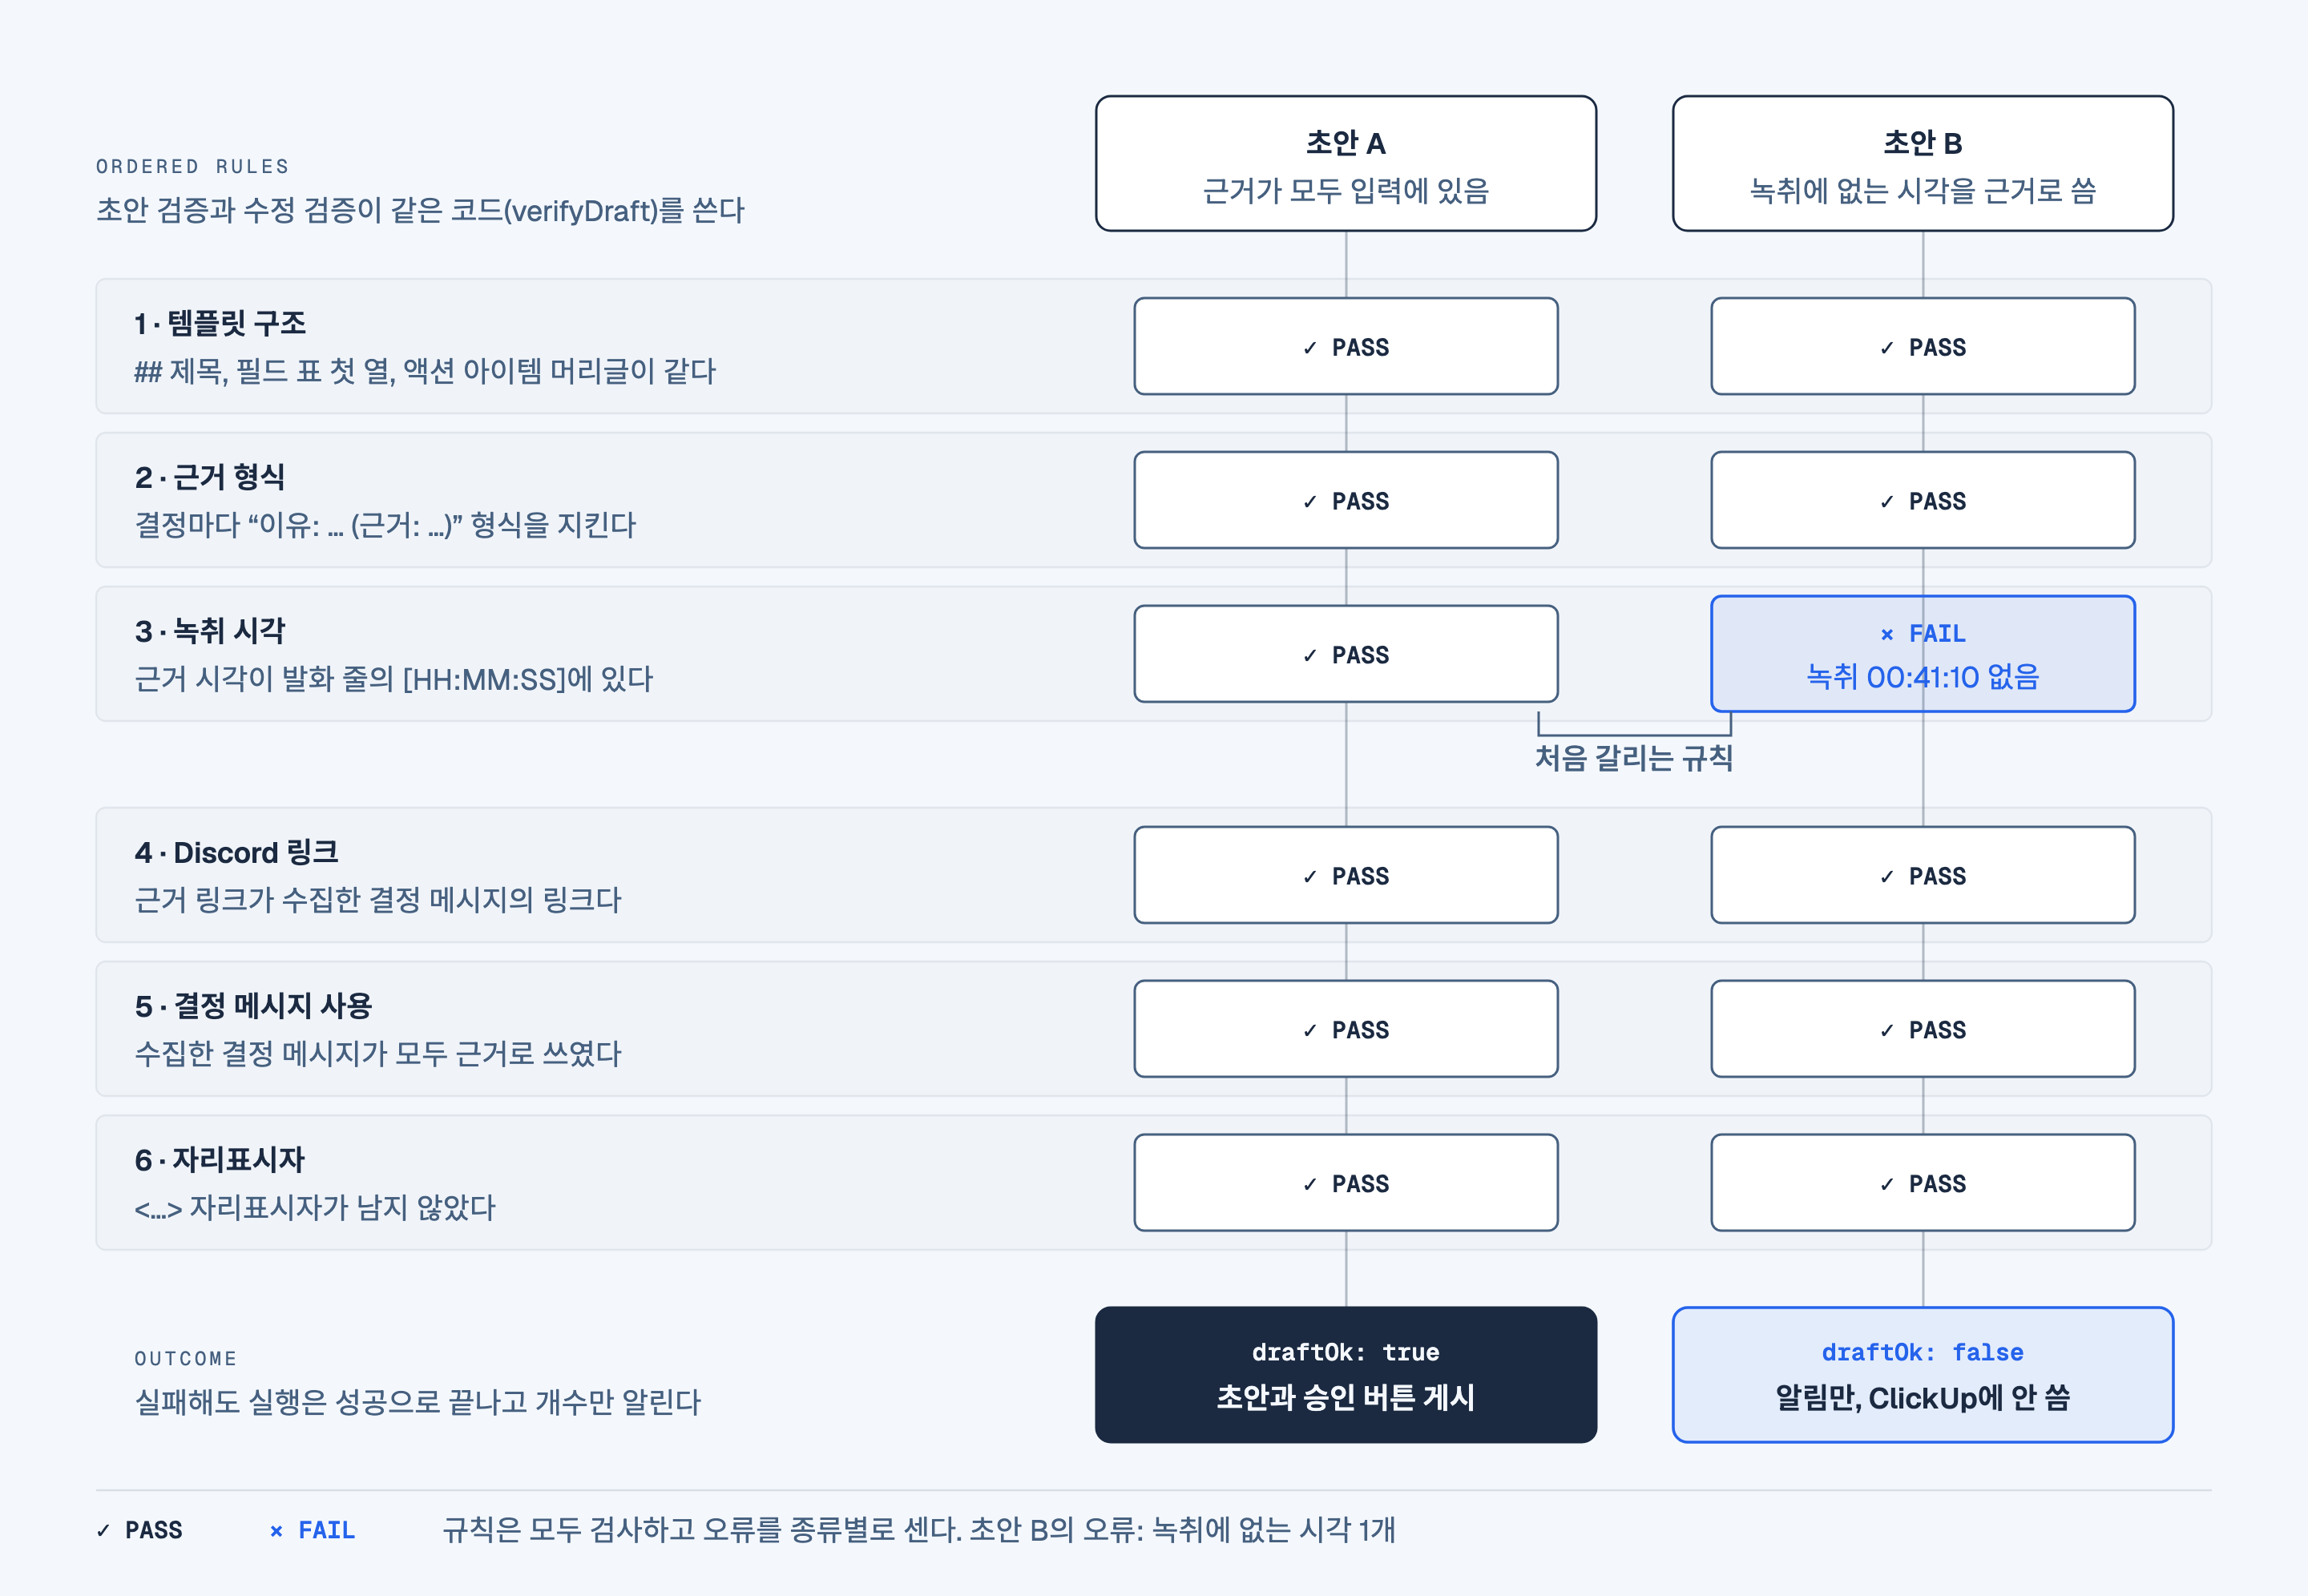
LLM 자체 검토 대신 Code 노드가 템플릿 구조, 근거 형식, 녹취 시각, Discord 링크, 결정 누락, 자리표시자 여섯 규칙을 0.07초에 검사합니다. 녹취와 채팅은 태그로 감싸 데이터로만 넘겨 프롬프트 인젝션 위험을 줄였습니다.
근거 검증 여섯 규칙 다이어그램
근거 검증 여섯 규칙. 근거가 모두 입력에 있는 초안 A는 통과하고, 녹취에 없는 시각을 근거로 쓴 초안 B는 ClickUp에 쓰지 않습니다
승인과 기록
승인은 Discord 버튼(3일 대기)으로 팀원 누구나 하고, 기록 뒤 ClickUp 페이지를 다시 읽어 LCS로 대조합니다.

02SKILLS기술 스택

Language
  • Java 17
  • Python
  • JavaScript
  • React.js
Backend
  • Spring Boot
  • Spring Batch
  • JPA
  • Querydsl
  • jOOQ
  • FastAPI
Database
  • PostgreSQL
  • MongoDB
  • Redis
Infrastructure
  • AWS ECS Fargate
  • AWS CDK(Java)
  • Terraform
  • Docker
  • GitHub Actions
Observability
  • Prometheus
  • Grafana
  • Loki
  • k6
AI Tools
  • Claude Code
  • Codex
  • Agent Skills

03OPEN SOURCE오픈소스

  • GitHub Spec Kit PR #4964 병합

    확장 명령 목록이 에이전트에 실제 등록된 이름과 다르게 보이던 문제를 고치고 회귀 테스트 추가

    github/spec-kit
  • Microsoft MarkItDown PR #2412 병합

    CSV 변환 때 표가 사라지는 문제를 Issue #2411로 보고하고 줄바꿈 처리를 고침, 테스트 15개 추가

    microsoft/markitdown

04EDUCATION학력과 교육

  • 영남대학교 수학과(전공 평점 4.27/4.5), 컴퓨터공학과 복수전공(3.91/4.5)
  • LG U+ 유레카 3기 백엔드 과정 1,080시간
  • 삼성청년SW·AI아카데미(SSAFY) 16기 Java 트랙

자격

  • 정보처리기사
  • SQLD
  • ADsP
  • TOEIC Speaking IH

수상과 병역

  • 종합 프로젝트 우수상, TR1L
  • 최종 융합 프로젝트 우수상, Holliverse
  • 영남대 자연과학대학장 우등상
  • 정보통신병 복무